Más de 9 millones de trayectos reales, 20 meses de operación y una lección: los datos importan más que el modelo.
Todo optimizador de rutas parte de una pregunta sencilla: ¿cuánto se tarda en ir de cada punto a cada otro? La respuesta es una matriz de tiempos, una tabla con el tiempo de cada trayecto entre todas las paradas. Sobre ella el algoritmo decide el orden de las entregas, cuántos vehículos hacen falta y si una ruta cumple sus ventanas horarias.
Hay un problema: esa matriz suele venir de un motor de rutas que calcula tiempos teóricos, a partir de la red de carreteras y sus velocidades. No sabe lo que cuesta maniobrar en una calle estrecha, ni cómo cambia el tráfico a lo largo del día. Tampoco sabe nada del tiempo que el repartidor pasa en cada parada.
Si la matriz se equivoca, el optimizador también, aunque su algoritmo sea excelente. Por eso hemos construido modelos que corrigen esos tiempos teóricos con el histórico real de reparto. Esto es lo que hemos hecho y lo que hemos aprendido.
El histórico real tampoco es la verdad
La idea parece obvia: tenemos millones de trayectos reales, así que basta con enseñarle a un modelo la diferencia entre lo teórico y lo real. Pero en cuanto abres los datos aparecen dos problemas.
El primero es la calidad. Un histórico operativo no se diseñó para entrenar modelos. Tiene horas mal fichadas, trayectos cortados por los límites del sistema de extracción y entregas registradas en el sitio equivocado.
El segundo es más sutil. El tiempo entre dos paradas no es solo conducción: incluye aparcar, descargar, esperar al destinatario y volver al vehículo. Si entrenas un modelo de conducción con ese tiempo bruto, "aprende" que las calles con clientes que reciben mucha mercancía están atascadas. Es falso: allí no hay más tráfico, hay más descarga.
Paso 1: auditar antes de entrenar
Cada trayecto pasa una auditoría y queda clasificado como válido, sospechoso o inválido. Se comprueba, entre otras cosas:
- La física. Por encima de 120 km/h de velocidad implícita un registro es sospechoso; por encima de 140 km/h, imposible para un vehículo de reparto.
- La coherencia con el tiempo teórico. En trayectos de al menos 15 minutos, un tiempo real inferior al 60 % del teórico o superior al doble levanta una alerta.
- Los topes técnicos. Algunos registros aparecen cortados justo en el límite del sistema de extracción: no son tiempos reales, son el techo del sistema.
- La carga anómala. Detectamos volúmenes atípicos con estadística robusta (medianas y desviaciones absolutas en escala logarítmica), en lugar de medias que un solo valor extremo puede deformar.
La auditoría no modifica los datos originales: añade marcas y motivos, de modo que siempre podemos explicar por qué se descartó cada registro. El resultado: el 93,5 % de los trayectos es válido, algo más del 1 % es sospechoso y casi medio millón se marca como inválido.
Paso 2: separar conducir de descargar sin hacer trampa
Usamos dos modelos: uno aprende la descarga y otro la conducción. El riesgo es que se contaminen entre sí: si el de conducción se entrena con los mismos datos que ya vio el de descarga, los errores de uno se esconden en el otro.
La solución fue una partición estricta por fechas. Ordenamos todos los días del histórico y asignamos uno de cada tres al modelo de descarga (145 días) y los dos restantes al de conducción (289 días). Ningún día aparece en los dos grupos.
Paso 3: el modelo de descarga
La descarga no está donde parece La descarga en una parada B no está dentro del trayecto que llega a B, sino en el siguiente, el que sale de B hacia C: el reloj de ese tramo empieza cuando el vehículo llega a B e incluye todo lo que pasa allí antes de arrancar. Por eso asociamos la mercancía entregada en B con el tiempo del tramo B→C. Con la alineación equivocada, el modelo relaciona la carga de una parada con el tiempo de otra.
Qué predice y con qué No medimos la descarga directamente: la estimamos como lo que sobra del tramo al restar la conducción teórica, nunca por debajo de la descarga planificada y con un tope de 30 minutos. Para predecirla, el modelo usa:
- Dónde está la parada: ubicación y entorno, según la clasificación europea de grado de urbanización (urbano, periurbano o rural) y la población de la zona.
- Qué se entrega: volumen de cada tipo de mercancía, total y proporción de cada tipo.
- Lo planificado: el tiempo de descarga previsto.
A propósito, no usa el tiempo teórico de conducción, la distancia ni el punto de origen, para que no pueda "copiar" información del trayecto. Además, impusimos una restricción monótona: más mercancía nunca puede dar menos tiempo de descarga. Es una regla física que el modelo debe respetar aunque los datos tengan ruido.
El modelo definitivo se entrenó con 2,5 millones de paradas. En validación con días no vistos, reducía el error un 27% frente a la descarga planificada, y el modelo final mantiene esa mejora.
¿Cuánto pesa realmente la carga? Usamos un truco contrafactual: el modelo predice cada parada dos veces, con su carga real y como si no se entregara nada. La diferencia es el efecto de la mercancía. Así separamos lo que cuesta parar de lo que cuesta descargar:
- Una parada típica consume algo más de dos minutos.
- De ellos, la carga aporta en mediana solo unos 14 segundos, aunque en el 10 % de entregas más grandes supera el minuto.
- La variable más importante sigue siendo el entorno: aparcar en el centro de una ciudad o en una calle de pueblo pesa más que entregar tres bultos o siete.
Paso 4: el modelo de conducción
Con la descarga estimada y restada, lo que queda es conducción. El modelo aprende una sola cosa: cuánto se desvía el tiempo real del teórico, como un cociente en escala logarítmica. Usa:
- La duración teórica y el tipo de tramo (menos de 5 minutos, 5-15, 15-30, 30-60 o más de una hora).
- El origen y el destino, con su grado de urbanización y población.
- La hora y el día de la semana, codificados de forma cíclica para que las 23:00 y las 00:00 queden "cerca".
El tiempo final es el teórico multiplicado por el factor predicho, sin suelos artificiales: si la realidad es más rápida que la teoría, el modelo lo refleja (en torno al 8 % de los casos). Antes de entrenar eliminamos solo los valores extremadamente altos de cada tipo de tramo, unos 1.300 trayectos de más de 5,4 millones.
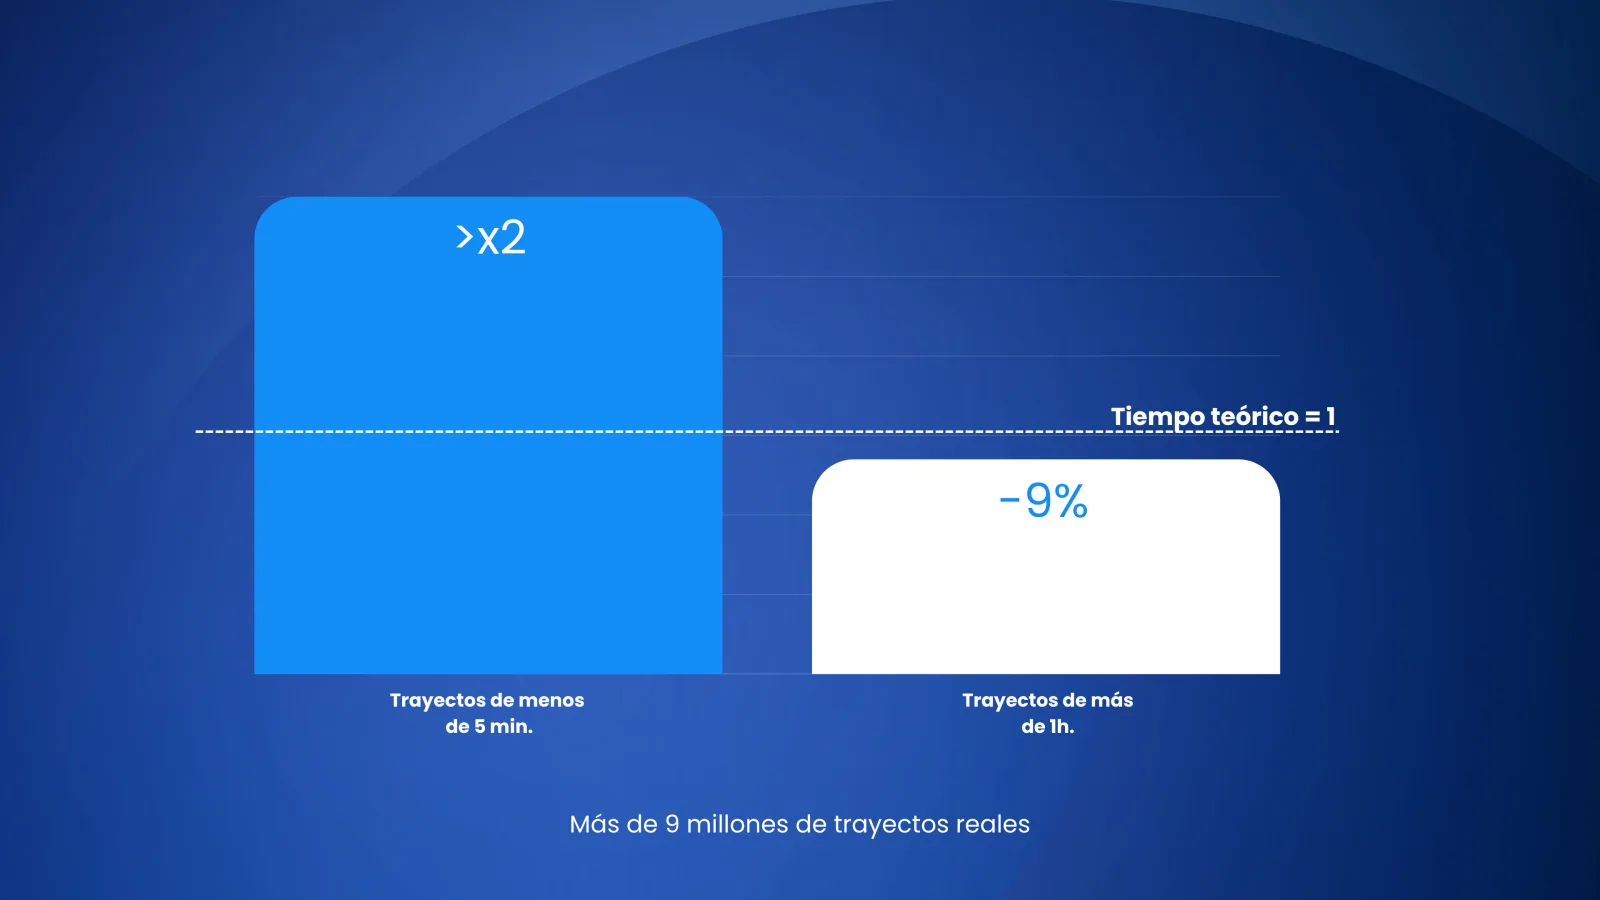
El motor teórico falla de forma sistemática Tramo teórico Tiempo real / teórico (mediana) Menos de 5 min 2,13 5-15 min 1,26 15-30 min 1,08 30-60 min 0,98 Más de 60 min 0,91
En los trayectos cortos, que son la mayoría en reparto urbano, la conducción real es más del doble de la teórica, probablemente por maniobras, aparcamiento, calles de sentido único y arranques. En los largos pasa lo contrario: por carretera se tarda algo menos de lo previsto. Un único factor de corrección para todo sería un error.
También descubrimos que la hora del día aporta, pero bastante menos de lo esperado. Lo que más pesa es el tipo de tramo y el entorno.
Paso 5: una matriz que cambia con la hora
Con el modelo de conducción generamos una matriz por cada hora del día. Cada parada usa la de la hora a la que el vehículo sale de ella, interpolando entre horas.
Aquí aparece un problema circular: la hora de salida depende de la ruta, y la ruta depende de la matriz. Lo resolvemos por iteración: optimizamos, estimamos la hora de salida de cada parada, recalculamos la matriz y volvemos a optimizar, normalmente dos veces. Cuando el orden de las paradas ya está fijado, ni siquiera hace falta la matriz completa: el modelo predice directamente cada tramo a su hora.
Resultados: Validamos el enfoque sobre un piloto de 40 días y 775.000 trayectos, con validación cruzada temporal (siempre en días no vistos). Frente al tiempo teórico:
- El error medio baja un 27 %, y el error en el 10 % de los peores casos, un 29 %.
- En trayectos de más de una hora, el error baja un 40 %.
- En el resto de tramos, la mejora está entre el 25 % y el 28 %.
- Frente a una corrección simple (un factor fijo por tipo de tramo), el modelo sigue siendo un 17 % mejor.
El modelo definitivo, entrenado con 5,4 millones de trayectos, reproduce la misma mejora del 27 %: la señal de que generaliza en lugar de memorizar.
Lo que nos llevamos
- 1Los datos antes que el modelo. La mayor parte de la mejora vino de auditar, alinear y separar correctamente, no de complicar el algoritmo.
- 2Separar los efectos importa. Conducir, parar y descargar son fenómenos distintos; mezclarlos da un modelo que acierta por los motivos equivocados.
- 3Validar sin trampas. Particiones por fechas y validación en días no vistos: son las cifras que se verán en la calle.
- 4Dejar que los datos contradigan la intuición. Pensábamos que la carga y el tráfico dominarían, y el tipo de tramo y el entorno pesan mucho más.
- 5Lo corto engaña. El error del tiempo teórico está en los trayectos de pocos minutos, justo los más repetidos en reparto urbano.
La matriz de tiempos es la parte menos visible de un optimizador de rutas, pero todo lo demás depende de ella. Cuanto más se parece a la calle, mejores son las rutas.